ERP multi-tenant
Um ERP do zero (financeiro, contabilidade, contas a pagar e RH) construído pra aguentar mais de um cliente no mesmo banco sem vazar linha de um pro outro.
O problema
Empresa pequena que compra ERP pronto paga por módulo que não usa e não consegue mudar nada. Empresa que manda fazer sob medida paga caro e fica presa em quem fez. Eu quis entender o que existe no meio: um sistema onde cada cliente é um tenant no mesmo banco, com os mesmos módulos, e a diferença entre eles é configuração, não código.
O interessante não é escrever as telas. É que a partir do momento em que dois clientes dividem um banco, todo erro de programação vira vazamento de dado de um cliente pro outro. É esse o problema real do projeto, e é sobre ele que são as decisões abaixo.
Decisões técnicas
Filtro global de tenant que falha fechado, não aberto
Contra o quê: repetir WHERE tenant_id = @x em cada consulta, que era o desenho anterior, e um filtro global que, sem tenant resolvido, liberava todas as linhas de todos os tenants.
Hoje o DbContext aplica um filtro automático em toda entidade que implementa ITenantScoped. Sem tenant no contexto, a consulta não devolve nada: em vez de devolver tudo.
O que custou: quem precisa ler cross-tenant de propósito agora tem que escrever IgnoreQueryFilters() explicitamente, com um comentário do lado dizendo por que aquela leitura atravessa tenants; um teste de arquitetura quebra o build se o comentário faltar. Mais atrito no caminho raro, em troca de tornar o erro comum impossível. A fábrica de design-time roda sem contexto e portanto filtra tudo; é inofensivo porque design-time só roda migration, mas é o tipo de canto que precisa estar documentado no próprio código pra ninguém “consertar” errado depois.
Um atributo por controller, que declara e aplica a permissão
Contra o quê: cada action reescrevendo a própria checagem de acesso.
A disciplina falhou na prática: houve um commit que vazou justamente porque confiou na checagem existente, não porque alguém a desligou. Então a autorização virou um atributo único no topo do controller, [TenantModule("HR.Employees")], que declara qual recurso aquele controller expõe e faz o gate na mesma linha.
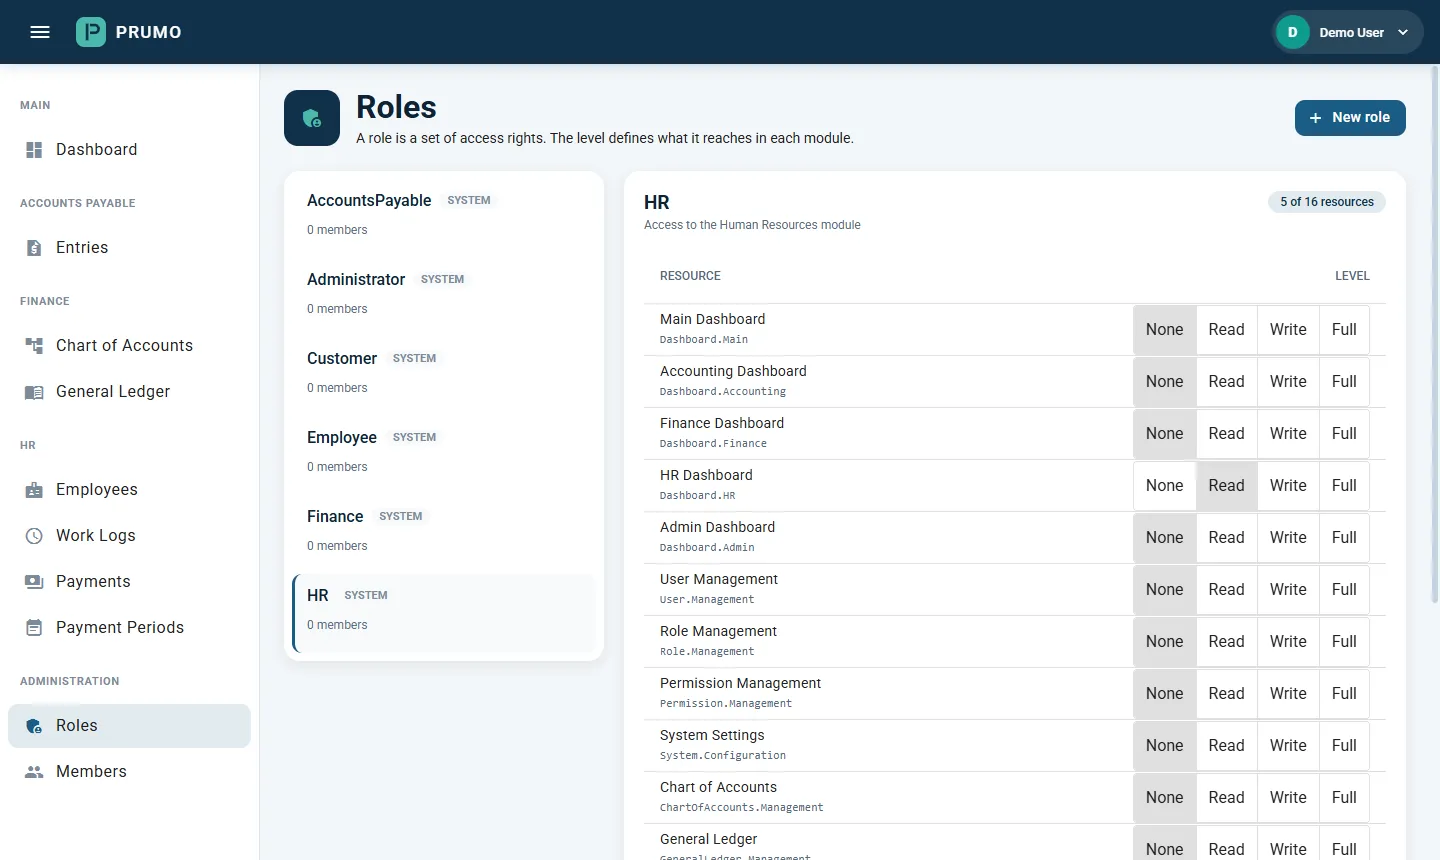
O que custou: os dados são lidos pelo tenant da rota (api/tenants/{tenantId}/…), então é contra ele que o atributo prova que o usuário é membro, e um token selecionado pra outro tenant recebe 403. Autorizar contra um tenant e ler de outro é pior do que não autorizar. Isso significa que rota e token passaram a ser acoplados, e um cliente que monte a URL “errada” recebe um erro em vez do dado.
Um teste de arquitetura que quebra o build quando alguém esquece
Contra o quê: confiar em revisão de código pra lembrar do atributo.
Existe um teste que varre os controllers e falha se alguma action sob {tenantId} ficou sem o gate. Endpoint novo escrito sem cuidado não passa.
O que custou: e essa é a parte que quase ninguém escreve: o teste pega o esquecimento, não o engano. Um segundo teste recusa código de recurso que não existe no catálogo, mas um controller de funcionários que declare HR.Payments, um código que existe e é o errado, passa nos dois e continua errado. A rede pega quem esqueceu, não quem escreveu bobagem. E saber exatamente onde a rede tem buraco é a diferença entre ter proteção e achar que tem.
A API conecta num usuário do banco que não pode mudar o schema
Contra o quê: a API conectando como postgres, que era como estava.
Superusuário ignora qualquer checagem de permissão: um DROP SCHEMA public CASCADE perdido leva as 25 tabelas junto, e nenhum grant impede. Hoje são dois usuários no banco: um dono das tabelas e o único que roda DDL, e outro que só lê e escreve dado. A API conecta com o segundo. Transferir a posse das tabelas era metade do trabalho, não detalhe: tirar o CREATE com a aplicação ainda dona das tabelas deixaria o DROP TABLE aberto do mesmo jeito.
O que custou: a API parou de rodar migration sozinha ao subir, porque era isso que a obrigava a ter permissão de DDL. Migration virou um passo separado do deploy. E pra um schema desatualizado não quebrar depois num lugar que não explica a causa, a API confere na subida se falta migration e se recusa a servir, dizendo o comando que tem que rodar. Deploy que esquece a migration agora não sobe, em vez de subir quebrado.
Uma máquina de conta fixa, não um serviço que escala a zero
Contra o quê: a primeira versão, que rodou ponta a ponta na Azure: Container Apps, ACR, Key Vault e PostgreSQL gerenciado, escalando a zero quando ninguém usava.
O Container Apps cobra pelo cold start, e o PostgreSQL gerenciado tem um piso de preço que não cai com uso nenhum. O desenho atual é na AWS: uma instância Lightsail de 2 GB em São Paulo rodando quatro containers com docker compose (Caddy pro TLS, o nginx do Angular, a API e o PostgreSQL 17), com as imagens no ECR, publicadas pelo GitHub Actions por OIDC, sem chave da AWS guardada no repositório. Cerca de US$ 14 por mês, fixos.
O que custou: é uma máquina só, sem a redundância que um serviço gerenciado daria. É o formato certo pra um sistema que está começando, não pra escala.
O que ficou de fora
Cache. Havia um módulo de Redis escrito, funcionando e não conectado a nada: a API tinha um ICacheService que ninguém nunca injetou. Preferi apagar a fingir que fazia parte do sistema. Volta quando o cache justificar o próprio custo.
A versão da Azure foi derrubada. A da AWS é toda em Terraform, e cada pull request passa por fmt e validate contra o provider real antes de entrar.
O ERP ganhou o primeiro cliente, e por isso o código deixou de ser público.
[Stack]
- .NET
- PostgreSQL
- Angular
- Terraform
- AWS
- Docker
[Links]